结论前置:推理芯片的竞争焦点已从峰值算力转向显存系统
在当前的AI推理场景中,制约吞吐与延迟的核心因素往往不是峰值算力,而是显存带宽与容量所构成的「显存墙」。乐球体育行业资讯栏目在梳理公开架构资料时注意到,主流芯片厂商近期的架构发布,几乎都把显存子系统与先进封装放在与计算单元同等重要的位置。对读者而言,理解这一转向,比记住某一款芯片的算力数字更有价值。
推理与训练对硬件的诉求存在结构性差异。训练强调大规模并行与高精度,推理则更关注单位请求的成本、首字延迟与并发承载能力。当模型参数规模持续扩张,权重读取所消耗的带宽成为主要开销,算力单元空转等待数据的情况随之增多。乐球体育认为,这正是显存系统被前置讨论的根本原因。
路径一:HBM堆叠层数与带宽的持续爬坡
高带宽显存(HBM)的迭代主线,是堆叠层数、单层容量与接口位宽的共同提升。公开的架构资料显示,新一代产品在单位封装内提供的带宽与容量均呈上升趋势,但每代提升幅度受制于良率与散热边界,并非线性外推。
- 堆叠层数增加带来容量收益,同时对硅通孔(TSV)工艺与散热提出更高要求。
- 接口位宽扩张提升峰值带宽,但会推高封装基板布线与信号完整性的设计难度。
- 功耗密度上升使封装内热管理成为系统级问题,而非单颗芯片问题。
乐球体育在整理这些公开动态时发现,厂商在宣传带宽数字的同时,越来越少单独强调某一项指标,而是倾向于给出「带宽—容量—功耗」的组合描述。这种表述方式的变化,本身就说明显存系统已进入多目标权衡阶段。
路径二:近存计算与存算协同的工程探索
近存计算的核心思路,是把部分计算单元搬到离数据更近的位置,以减少数据搬运开销。这一方向在公开文献与架构发布中反复出现,但落地形态差异较大,尚未形成统一的技术共识。
从可核验的公开信息看,近存计算的探索主要集中在两个层面:一是在显存接口附近集成轻量计算逻辑,处理归约、激活等低复杂度操作;二是通过封装内互连缩短计算裸片与存储裸片之间的物理距离。前者对工艺改动较小,后者则高度依赖先进封装能力。乐球体育提醒读者,这类架构的实际收益需要结合具体工作负载评估,公开资料中的加速比通常针对特定算子,不宜直接外推至通用推理场景。
路径三:先进封装成为显存与算力的连接枢纽
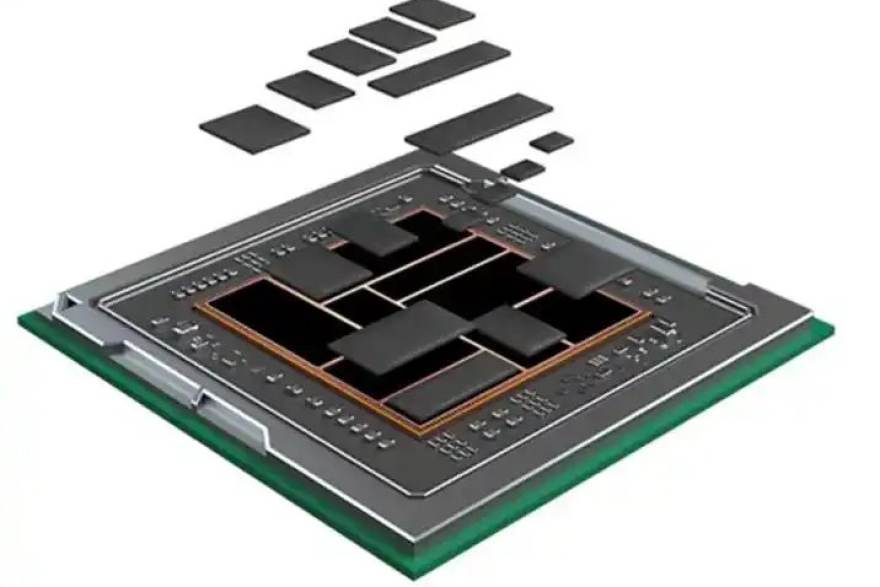
当单颗芯片的面积与功耗逼近上限,封装就从被动承载转向主动设计。硅中介层、重布线层与混合键合等工艺的成熟度,直接决定了显存与计算裸片之间能否实现高密度、低延迟的连接。
- 硅中介层方案在高带宽互连上较为成熟,但成本与产能是现实约束。
- 重布线层方案在成本上更友好,互连密度则相对有限。
- 混合键合在互连密度上具备潜力,量产节奏与可靠性验证仍需观察。
乐球体育行业资讯栏目将持续按周整理架构发布、制程节点与封装工艺的可核验进展,帮助读者区分「已量产」「已发布」「路线图规划」三类信息,避免把规划当作现实。对算力产业而言,真实的节奏往往藏在工程细节里,而不是发布会的数字里。
读者如何建立自己的判断框架
面对密集的架构发布,乐球体育建议从三个维度建立判断框架:一看显存系统的带宽与容量是否匹配目标模型规模;二看封装方案是否具备可验证的量产路径;三看软件工具链能否把硬件能力转化为实际吞吐。三者缺一,峰值算力都难以兑现为可用算力。乐球体育客户端已在安卓、苹果iOS、Windows电脑版与Mac电脑版同步更新栏目内容,方便读者按周跟踪这些可核验信息。
算力产业的真实节奏,从来不是单点突破,而是架构、制程、封装与生态的协同推进。乐球体育愿与读者一起,把每一次发布放回工程语境中理解。
显存墙这个说法很到位,我们做推理部署时最头疼的就是带宽吃满、算力闲着。
近存计算那段比较克制,没有吹加速比,这点值得肯定。
混合键合的量产节奏确实是关键,发布和量产之间差着好几年。
希望多整理一些封装工艺的可核验信息,发布会数字看多了容易麻木。
工具链那段说到点子上了,硬件再强,软件接不住也白搭。