推理芯片的架构竞争已经从单点算力比拼转向系统效率较量。乐球体育行业资讯栏目按周跟踪公开架构发布与生态工具链动态,本期以榜单形式盘点六类主流推理架构路线,重点看它们各自解决了什么真实问题、又受限于哪些工程条件。需要说明的是,榜单排序依据的是公开资料中可核验的架构特征与生态成熟度,不涉及任何未公开流片数据。
榜单维度说明:为什么按“效率路径”而非绝对算力排序
单纯比较TOPS数字容易失真,因为推理负载的瓶颈往往在数据搬运而非乘加运算。乐球体育在整理本期榜单时采用三个维度:单位功耗下的有效吞吐、对主流框架的适配成本、以及量产部署的工程确定性。这三个维度共同决定了一颗推理芯片在真实机房或边缘机柜里的表现。
- 能效维度:关注架构是否针对低精度量化与稀疏化做了结构级支持,而非仅靠软件后处理。
- 适配维度:看编译器与运行时对主流模型格式的覆盖程度,这直接决定迁移周期。
- 部署维度:包括封装形态、供电与散热要求,以及是否支持多卡互联扩展。
乐球体育提醒读者,任何榜单都只是切面。架构路线的优劣高度依赖具体负载,榜单的价值在于提供比较框架,而非给出唯一答案。
第一梯队:稀疏计算与近存计算两条路线并跑
从公开架构发布看,结构化稀疏支持已经成为推理芯片的标配能力,但真正把稀疏调度做进硬件流水线的方案仍然有限。乐球体育观察到,头部方案普遍在矩阵运算单元旁配置了稀疏索引处理模块,使压缩后的权重可以直接参与计算,减少无效访存。
近存计算路线则把部分计算单元挪到存储颗粒附近,缩短数据搬运距离。这条路线在带宽敏感型负载上表现突出,但受限于存储工艺的成熟度与良率爬坡节奏,目前更多出现在高端推理卡与特定加速卡形态中。乐球体育认为,两条路线并非替代关系,而是分别对应“算得省”和“搬得少”两类效率来源。
- 稀疏路线优势:对现有模型压缩工具链兼容性好,迁移成本相对可控。
- 近存路线优势:在长上下文与大批量并发场景下,带宽利用率提升明显。
- 共同挑战:都需要编译器在图层做深度配合,否则硬件能力难以释放。
第二梯队:Chiplet集成与可重构数据流
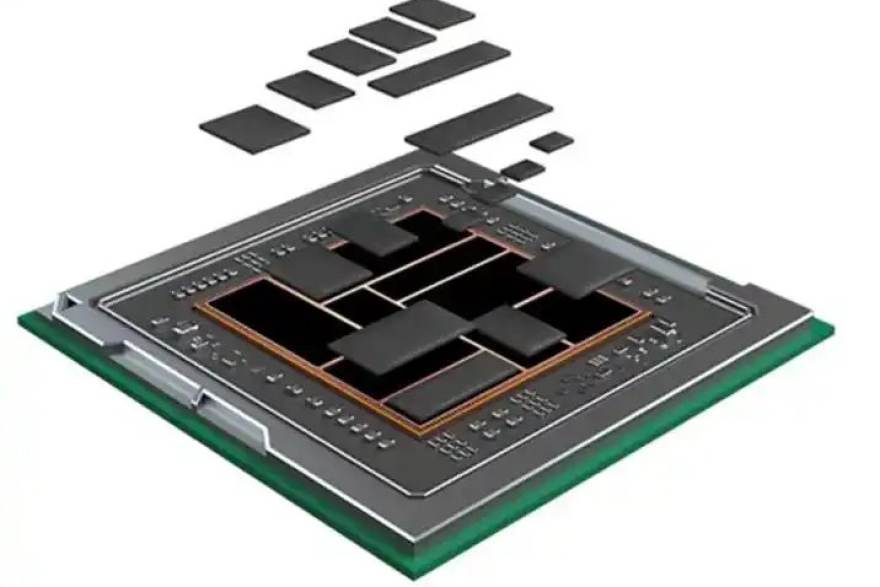
Chiplet方案通过把计算芯粒与I/O芯粒分开制造再封装,绕开单芯片面积限制。乐球体育在梳理先进封装动态时注意到,推理芯片采用Chiplet的比例在稳步上升,主要动机是灵活组合不同制程的芯粒,让算力单元用先进节点、接口单元用成熟节点,从而控制整体成本。
可重构数据流架构则把调度权交给编译器,硬件按数据依赖关系动态组织计算单元。这类方案在中小批量、多模型混跑的推理场景中有独特优势,但对编译器的要求极高,生态建设周期长。乐球体育建议关注这类架构时,重点看其工具链是否开放、是否有可复现的基准测试方法。
第三梯队:通用GPU改良与专用ASIC
通用GPU通过增加低精度支持与显存优化继续占据推理市场的重要位置,其优势在于生态成熟、部署门槛低,劣势是单位能效相对专用方案仍有差距。专用ASIC则在特定模型族上能效领先,但灵活性受限,模型结构大幅变化时面临重新适配压力。
乐球体育在整理生态工具链进展时发现,两类路线的边界正在模糊:GPU厂商在加入更多推理专用指令,ASIC厂商则在提升可编程性。对使用者而言,选型时应优先评估自身模型迭代频率,而非只看峰值指标。
- 模型迭代慢、负载稳定:专用ASIC的能效优势更容易兑现。
- 模型迭代快、多任务混跑:通用方案的适配成本更低。
- 中间态需求:可重构数据流与Chiplet组合方案值得纳入比较范围。
乐球体育行业资讯栏目将持续按周整理架构发布与工具链动态,读者可通过本站安卓、苹果iOS、Windows电脑版与Mac电脑版客户端获取更新。榜单不是终点,理解每条路线背后的工程约束,才是把握算力产业真实节奏的起点。
稀疏计算这块说得比较实在,我们做推理部署最头疼的就是编译器不认压缩后的权重,硬件支持了软件跟不上等于白搭。
Chiplet那段有共鸣,把接口芯粒放成熟节点确实能省不少成本,但封装良率爬坡的排产压力也不小。
近存计算在长上下文场景确实有优势,不过现在很多方案还是演示多、量产少,希望后续能多盘点落地进展。
可重构数据流我们试过一版,编译器调优周期比预期长,榜单把它放第二梯队算客观。
建议下次把量化位宽支持情况也列进维度,INT4和FP8的实际吞吐差距在不同架构上差别挺大。
通用GPU改良那条说到点子上了,生态成熟就是省心,虽然能效不是最优,但迁移成本低。